¡Hola a todos!
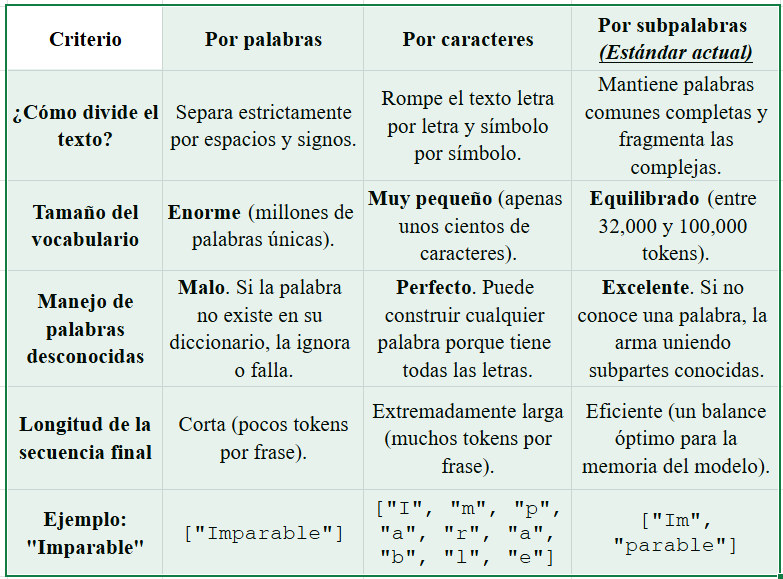
Quiero compartir con ustedes un breve resumen sobre un concepto fundamental en la Inteligencia Artificial: la tokenización. Como saben, los modelos de lenguaje (LLM) no leen palabras como nosotros, sino números. El proceso de traducir nuestro texto a esos números es vital para entender cómo procesan la información. Les dejo un cuadro comparativo con los enfoques principales y una breve explicación de BPE (Byte Pair Encoding). ¡Espero que les sea de utilidad para sus proyectos y debates sobre IA! Quedo atenta a sus comentarios.
El algoritmo más usado hoy en día se llama BPE (Byte Pair Encoding). No decide cómo cortar las palabras por reglas gramaticales, sino por pura estadística. Funciona así durante su entrenamiento:
- Punto de partida: Toma todo el texto de entrenamiento y lo separa inicialmente letra por letra (caracteres individuales).
- Conteo de pares: Busca cuál es el par de caracteres que más veces se repite consecutivamente. Por ejemplo, si "e" y "s" aparecen juntos millones de veces, los junta en un nuevo token: "es".
- Repetición en bucle: Repite este proceso miles de veces. En la siguiente ronda verá que "es" y "t" aparecen mucho juntos, así que crea "est".
- Criterio de parada: El proceso se detiene cuando el algoritmo alcanza el tamaño de vocabulario deseado (por ejemplo, 50,000 tokens únicos).
Las palabras que aparecen mucho en internet (como "computadora") terminan fusionadas en un solo token. Las palabras raras o con errores ortográficos se quedan divididas en las piezas más grandes que el algoritmo logre reconocer.